结合业务需求设计消息队列
背景
最近在写 ASM 的时候涉及到分布式任务调度,几年前我开发类似项目时会用 celery、dramatiq 等框架实现分布式调度功能。
但是业务复杂度上来之后会发现一些问题是现成框架较难解决的:
- 调度的颗粒度不够细:期望实现暂停、取消或恢复执行时,需要花费更多精力理解代码
- 问题难以追溯:在遇到丢任务、任务没有按预期执行或重试时,由于直接使用现成框架,调试排查问题原因会非常费劲
恰逢现在 AI 的 Coding 能力大幅提升,于是想着自己去实现一个贴合业务场景的消息队列,去除冗余复杂的功能。
消息队列的基本功能
消息队列是最基础的功能:暂存生产者发来的消息,等待消费者领取。进一步我们还可以根据高可用的设计原则延伸出两个场景:
-
怎么确保消息按预期消费?如果消费者处理消息过程中崩溃怎么办?
-
怎么知道目前消息队列的状态?有哪些消息被处理,哪些还在队列中?
消息确认
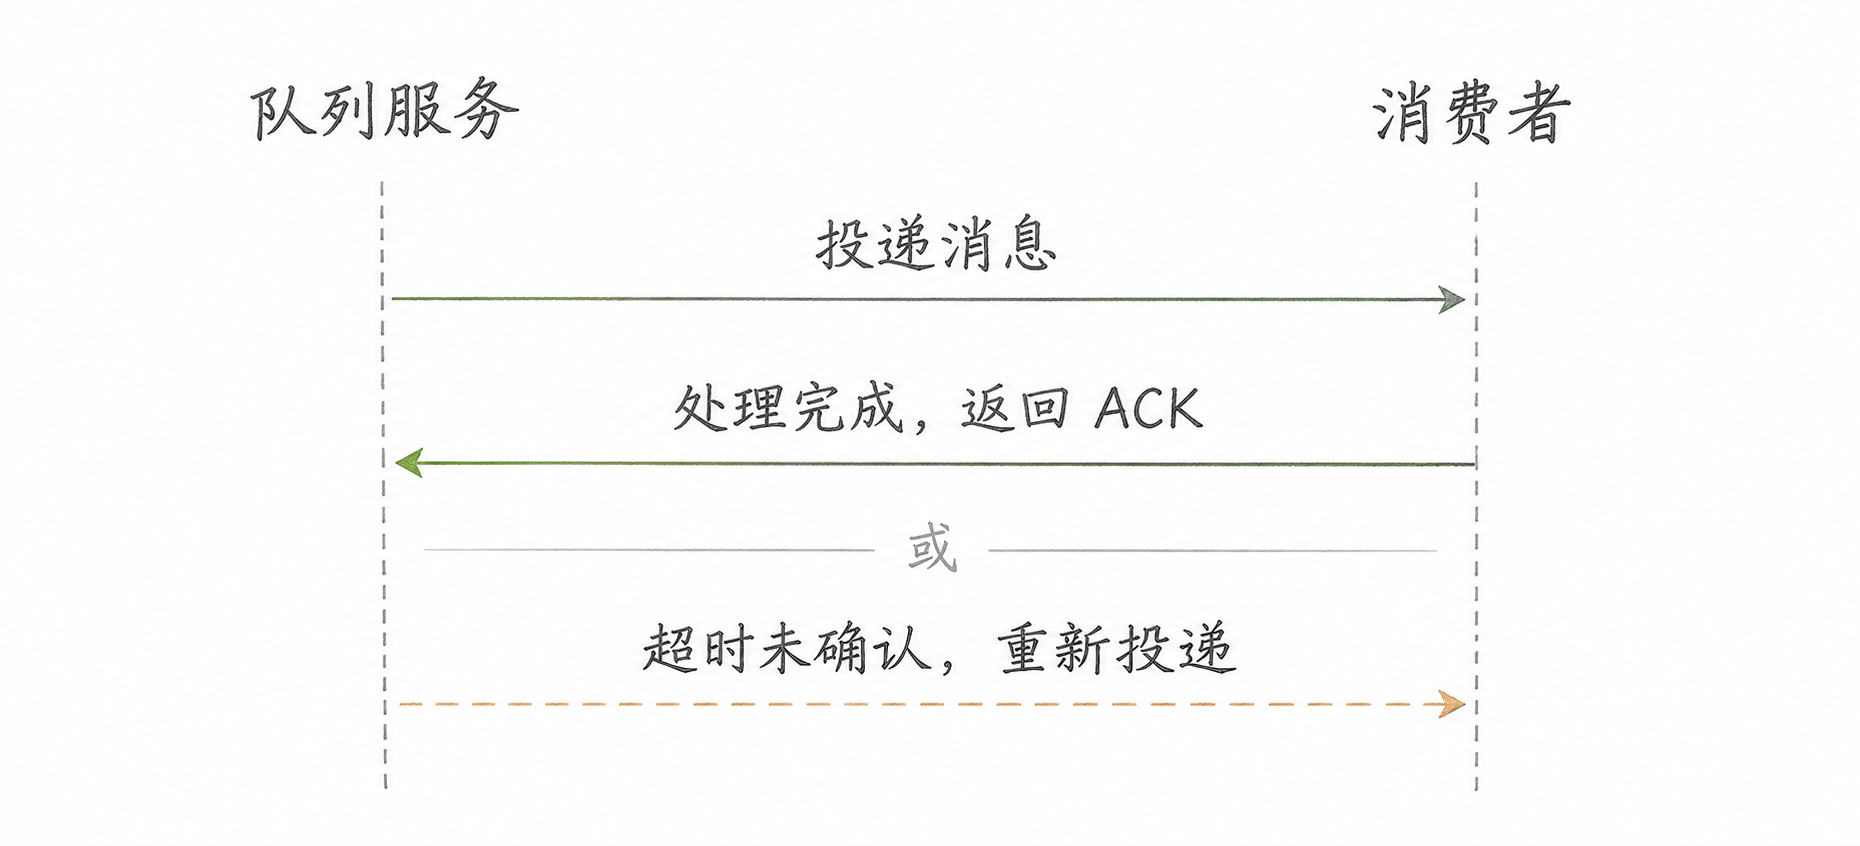
通过消息确认机制可以解决第一个问题,我们要求消费者在消费完接收到的消息后主动向队列发起一次确认请求,队列收到确认请求后再将消息删除;同时我们约定一个最长消费时间,当某条消息在被投递后超过了这个时间并且队列服务没有收到确认,那么系统需要提供能力将其重新放回队列中。
可观测性
当我们发现任务没有按照预期执行时,自然而然需要想到要有一些可观测的数据以帮助我们了解:
- 哪些消息已经被投递等待确认,哪些消息是待处理状态?
- 消息投递到哪个消费者了?
- 目前的消息大小有多大?
因此我们约定希望能够通过设计 HTTP 接口的方式帮助我们理解队列当前的最新状态。
ASM 的业务场景
上面介绍了消息队列一些最基本的需求,但是一个 ASM 的消息队列远不止于此,我们需要贴合业务场景去设计一些功能。
优先级
我们都知道 ASM 的逻辑本质上是一个编排,一个编排中包含多个执行组,一个执行组中包含多个原子插件。
有一些场景我们需要用到任务执行的优先级,例如单个执行组内如何控制插件的执行顺序,或者手动执行的插件优先级应该最高。
假定有4个优先级分别是低、中、高、极高,我们同时为每个 worker 集群创建4条 Redis Stream:
XGROUP CREATE rq:{cloud}:ready:max workers 0 MKSTREAMXGROUP CREATE rq:{cloud}:ready:high workers 0 MKSTREAMXGROUP CREATE rq:{cloud}:ready:medium workers 0 MKSTREAMXGROUP CREATE rq:{cloud}:ready:low workers 0 MKSTREAM当消息被投递时,队列服务根据投递时选择的优先级将消息放入对应的队列中;当消费者请求消费消息时,队列服务按最高 -> 高 → 中 → 低的顺序取消息,直到取满消费者所需的消费条数或消息不足为止。
在 Redis 8.10 里,一条 XREADGROUP 命令就能解决这个问题,下面四个 Stream 的排列顺序决定先从哪档取,MAXCOUNT 3 把四档合计的领取量限制为 3 条:
XREADGROUP GROUP workers queue-1 MAXCOUNT 3 STREAMS rq:{cloud}:ready:max rq:{cloud}:ready:high rq:{cloud}:ready:medium rq:{cloud}:ready:low > > > >消费者集群
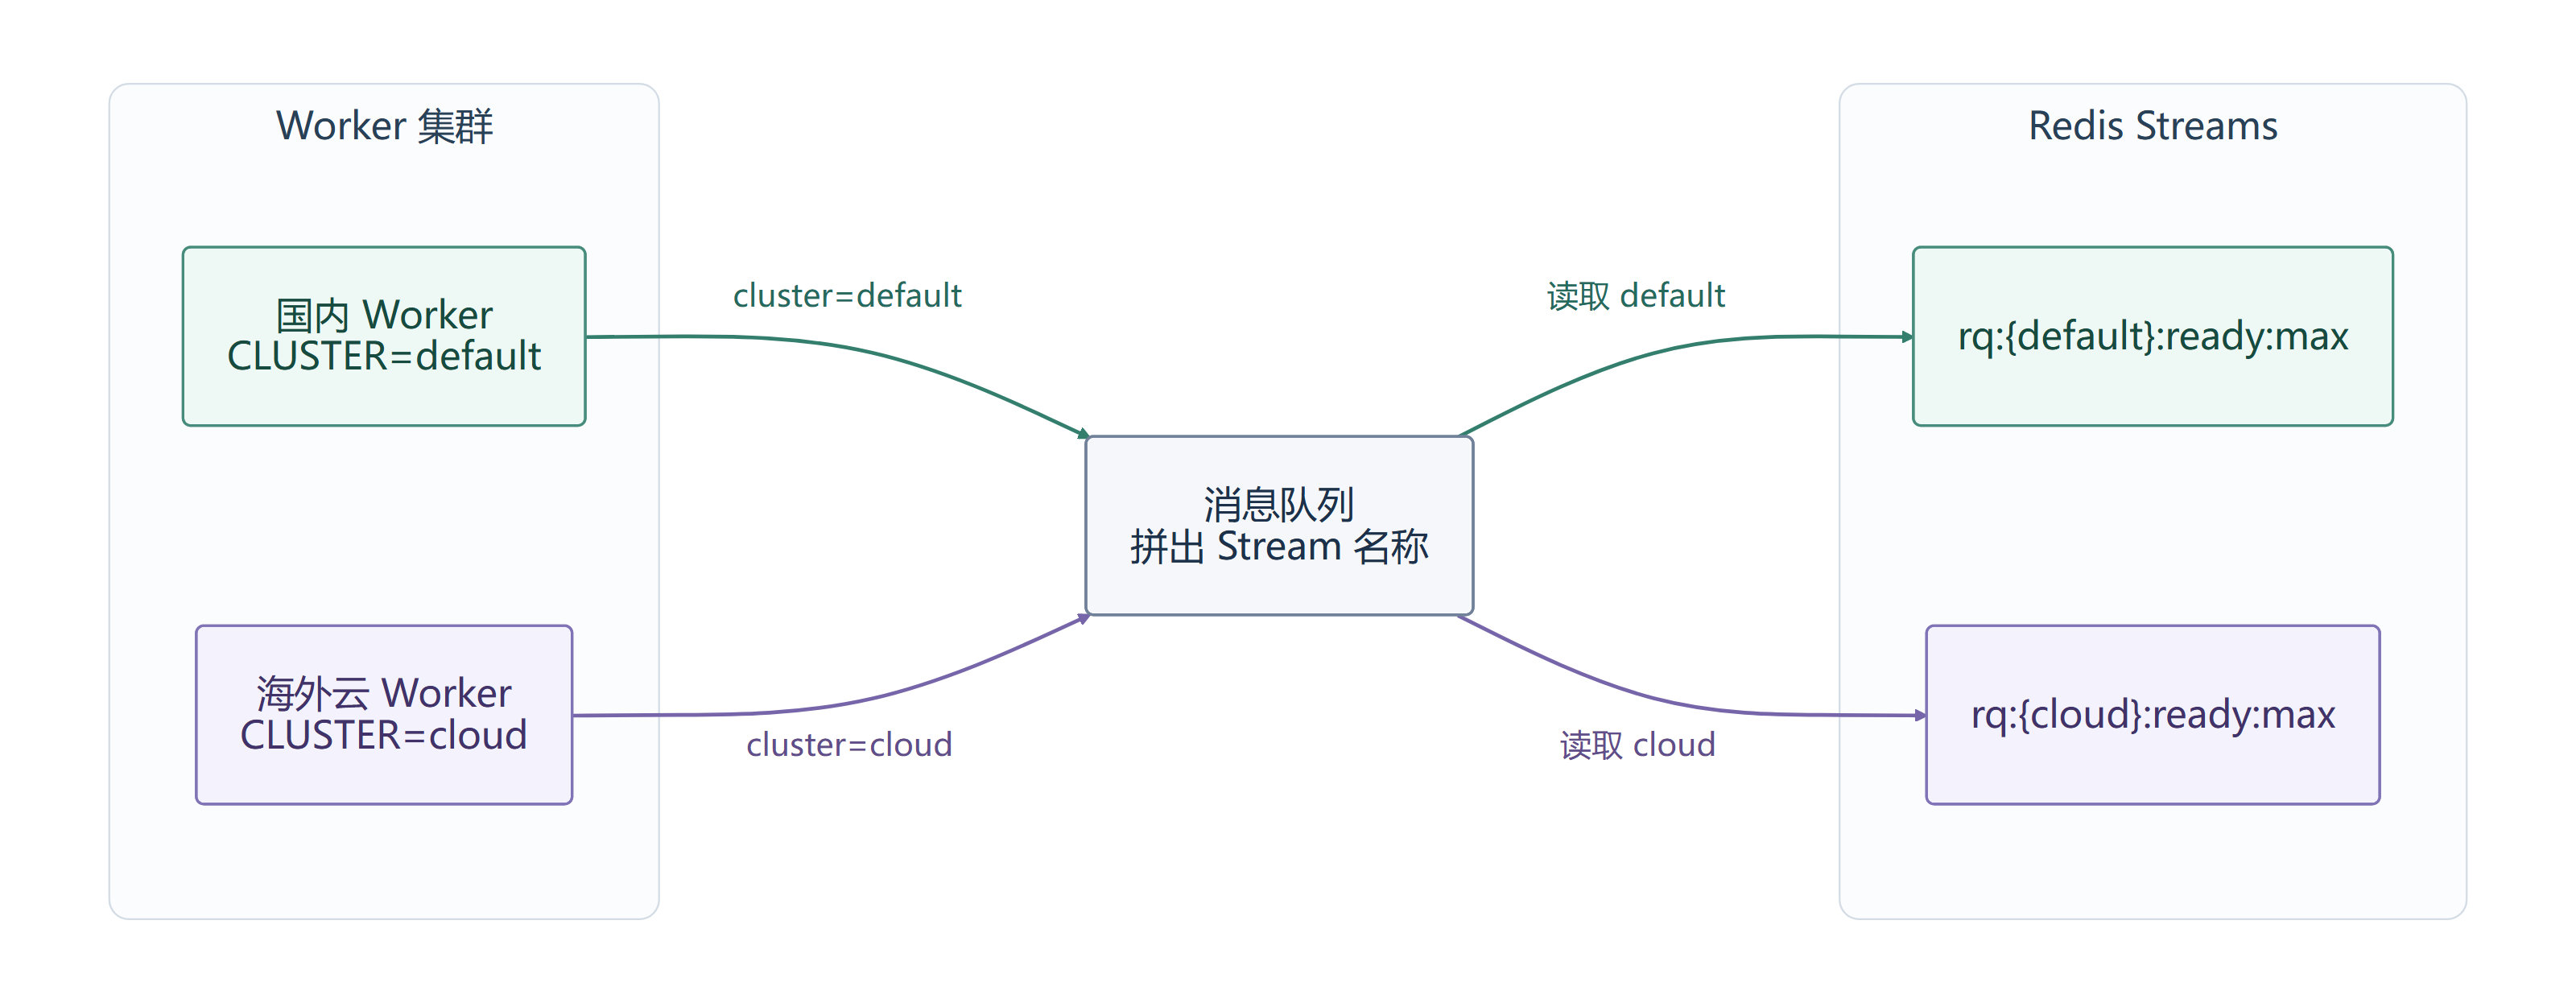
在 ASM 场景中我们通常会有多个不同的 worker 集群处理不同的任务目标或是编排。
我举个例子,在对一些海外目标做扫描时,我们可能希望使用海外的云集群,而对国内目标做扫描时我们会希望使用国内的集群。
这个实现就非常简单了,我们在 worker 部署时将集群标识作为环境变量部署上,之后每次 worker 领取任务时只需要将集群标识带上,消息队列根据集群标识拼出 Stream 名称,按 2.1 的方法领取消息。
编排运行的暂停与恢复
我们在使用 ASM 的过程中经常会碰上要暂停编排任务的场景,通常分两种情况:
- 因不可抗力手动暂停编排执行,过段时间手动恢复
- 编排不暂停,但任务不会被消费者接收,例如限制了扫描时段,消费者只能在白天接收并消费消息
以上需求需要三个组件共同配合:
- 编排服务:在暂停时停止向消息队列投递新任务,恢复后继续投递尚未发出的任务
- 队列服务:允许消费者归还已领取的消息,并支持延迟入队
- 消费端:在任务开始前检查编排状态,已暂停则归还消息,已取消则直接确认消息
通过上述逻辑我们可以让尚未开始的任务等待恢复后再执行,接下来主要介绍我们是如何在消息队列里实现归还和延迟入队功能的。假设 cloud 集群的一条高优先级消息已经被领走,队列服务可以按它的 Stream 条目 ID 归还这次领取:
XNACK rq:{cloud}:ready:high workers SILENT IDS 1 <条目ID>通过 SILENT 可以抵消本次投递计数,归还后消息依然存在于待确认列表中,之前说的 XREADGROUP 只能读取新消息,给它加上 CLAIM <超时毫秒数> 后下一个消费者就能接收到主动归还的消息:
XREADGROUP GROUP workers queue-2 MAXCOUNT 3 CLAIM 60000 STREAMS rq:{cloud}:ready:max rq:{cloud}:ready:high rq:{cloud}:ready:medium rq:{cloud}:ready:low > > > >然而在暂停场景下,如果立即将消息归还,下一个消费者又会马上读到它,发现编排依然在暂停,继续再归还,此时会产生无意义的 CPU 空转。
为了解决这个问题,我们可以为每个集群创建一个 Redis 有序集合,例如 rq:{cloud}:delayed,用分数记录每条消息最早可以再次领取的时间:
- 消费端交回本次领取的凭证和延迟时长。队列服务核对凭证,用
ZADD把消息的唯一标识、原优先级和内容一起存入延迟集合,再用XACKDEL确认并删除原 Stream 条目 - 队列服务定期用
ZRANGE ... BYSCORE取出分数小于或等于当前时间的消息,用XADD写回原集群、原优先级的 Stream,再用ZREM从延迟集合移除
# 07:50,消费者归还消息,要求延迟 30 分钟# 查询这次投递,核对消费者和投递次数是否与领取凭证一致XPENDING rq:{cloud}:ready:high workers 1795131900000-0 1795131900000-0 1
# 凭证匹配后,读取原消息,存入延迟集合,再确认并删除原条目XRANGE rq:{cloud}:ready:high 1795131900000-0 1795131900000-0ZADD rq:{cloud}:delayed 1795134000000 '{"message_id":"msg-42","priority":"high","payload":{"task_id":42}}'XACKDEL rq:{cloud}:ready:high workers DELREF IDS 1 1795131900000-0
# 08:20,以当前时间为上限,取一条已经到期的消息ZRANGE rq:{cloud}:delayed -inf 1795134000000 BYSCORE LIMIT 0 1
# 假设取到的是 msg-42,按原优先级写回 Stream,再移除刚取到的集合成员XADD rq:{cloud}:ready:high * message_id msg-42 payload '{"task_id":42}'ZREM rq:{cloud}:delayed '{"message_id":"msg-42","priority":"high","payload":{"task_id":42}}'
这样我们就能够解决编排运行时暂停、限制消费时间等场景的问题。
总结
至此我们已经实现了 ASM 业务场景下消费队列所需承载的所有功能:
- 消费者崩溃后,可以通过系统机制确保没有按时 ACK 的消息重回队列
- 通过四个 Redis Stream 实现插件的优先级功能,让高优先级的插件先执行
- 编排暂停或遇到扫描时间限制时,可以通过三个组件互相协同将消息延迟重回队列
- 希望 DEBUG 调试或了解观测数据时,可以通过接口获取当前消息队列的可观测数据
希望这篇文章能够帮助到你理解消息队列的核心功能,从而更好地结合实际业务场景设计一个更加贴合业务的消息队列服务。